
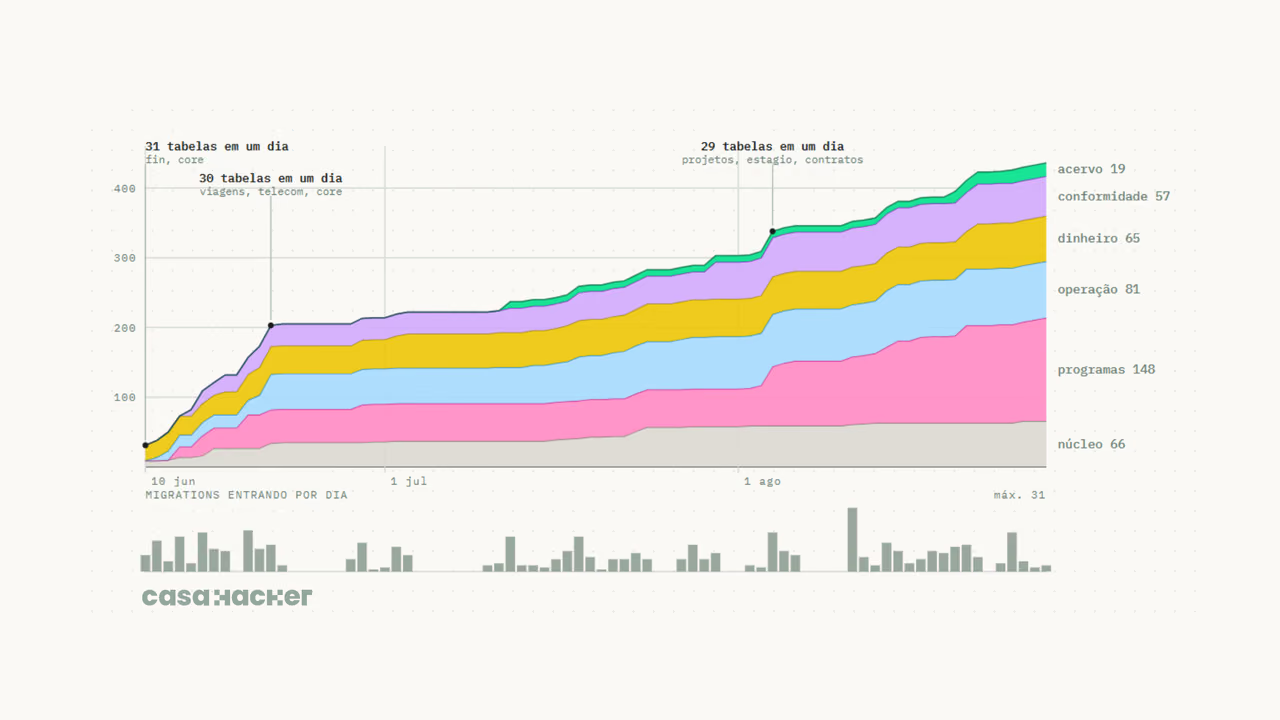
En los últimos años vi que TikTok se inundaba de creadores de contenido que enseñaban a usar mejor la inteligencia artificial, explorando trucos y consejos. Al mismo tiempo, empresas como Anthropic, OpenAI y diversas compañías chinas — que entraron en esa carrera hace ya bastante tiempo — pasaron a lanzar herramientas cada vez más orientadas a la productividad.
Mientras tanto, seguía en curso un fuerte debate sobre regulación y ética en IA, discutido desde hace años. Desde el inicio del año vengo rompiéndome la cabeza sobre cómo usar todo eso de forma más práctica en nuestro día a día. Muchas organizaciones lanzaron desafíos para que la inteligencia artificial generara impacto social — pero buena parte de ellos todavía parece distante de nuestra realidad. Distante porque, muchas veces, la ambición de resolver grandes problemas con IA aún suena un poco irrealista para nosotros.
A pesar de creer que todo eso sea posible, quizá la diferencia esté en la visión de mundo: estamos más preocupados por entender cómo la inteligencia artificial puede apoyarnos hoy — en la periferia, en la favela, en la realidad de nuestros programas de educación e innovación social aquí en la Casa Hacker. ¿Cómo puede ser más responsiva? ¿Cómo puede ayudarnos a tomar decisiones en el día a día?
Lo obvio no basta
En un primer momento, es común que organizaciones y empresas de tecnología crean que basta con lo obvio: comprar licencias de ChatGPT, Claude y otras herramientas, y distribuirlas entre los empleados de forma indiscriminada. Pero ¿dónde queda el cuidado con la protección de datos, con las informaciones estratégicas? ¿Cuánto se planifican realmente las personas para dejar sus datos accesibles a la inteligencia artificial?
Aquí en la Casa Hacker lidiamos con centenas de PDF todos los días — financiero, pedagógico, educación, innovación social — además de planillas, documentos de texto y archivos generados por sistemas de socios y de análisis de datos. Garantizar que todo eso sea leído y procesado con seguridad por la IA es un desafío enorme. En la práctica, ese desafío se vuelve aún mayor y más urgente que la propia adopción de la inteligencia artificial en nuestro cotidiano.
Fue con eso en mente que, hace algunos meses, comenzamos un desafío aquí en la Casa Hacker: unir nuestra base de datos y prepararla para la inteligencia artificial.
Esa es la parte de la historia que ya conté en otro texto. Ahora viene el resto — lo que de hecho hicimos, lo que salió mal y lo que aprendimos y sirve para cualquier organización que esté en el mismo lugar.
Parte 1 — Dónde estábamos
Una aclaración antes: cuando hablo de nuestro sistema, estoy hablando del Cockpit. Es la plataforma de gestión que construimos para la propia Casa Hacker — no es un producto que vendamos. Es donde viven los proyectos, los contratos, las finanzas, el presupuesto, las compras, las facturas, lo jurídico, las pasantías, el inventario de equipos y el registro pedagógico. Nació para sustituir un puñado de plataformas propietarias, cada una con su licencia, su base cerrada y su exportación en planilla.
En agosto de 2026, el Cockpit ya guardaba todo. Y no sabía responder casi nada.
Había miles de archivos PDF en el almacenamiento — contratos, facturas, comprobantes, actas, políticas, certificados — y el contenido de esos archivos era, para el sistema, un borrón. Existía también otra cosa, que considero más valiosa: 53 columnas de texto en prosa esparcidas por la base. El informe de un encuentro. El temario de un taller. La cláusula de un contrato. El registro de lo que de hecho ocurrió, escrito por gente del equipo — e inalcanzable por cualquier búsqueda.
Porque no existía búsqueda. El Cockpit tenía tres búsquedas separadas, una en cada módulo, y cada una sabía apenas de su propio rincón. Preguntar «¿dónde está la cláusula de rescisión del contrato con aquel proveedor?» era abrir carpetas.
El primer hallazgo: tres de los cuatro «no tenemos» ya existían
Comenzamos listando lo que faltaba. Eran cuatro cosas. Tres no faltaban.
La tecnología de búsqueda por significado ya estaba instalada en el servidor y nunca se había encendido — faltaba un comando de una línea. El programa que lee el texto de dentro de un PDF (incluso haciendo reconocimiento de caracteres en documentos escaneados) ya corría en producción y tiraba el resultado a la basura al final de cada consulta. Y el estándar para registrar de dónde vino un dato generado por IA ya existía, funcionando, en un rincón del sistema.
Con los nombres, para quien quiera comprobarlo: la búsqueda por significado es la extensión pgvector, que ya estaba instalada en el servidor y solo necesitaba un comando CREATE EXTENSION vector. La lectura de PDF es poppler, Tesseract, OCRmyPDF y Ghostscript — cuatro programas libres que ya viajaban dentro de nuestra imagen de contenedor, invocados en una consulta puntual y descartados enseguida. Y la procedencia era una tabla de diligencia que ya guardaba, para cada resultado, el modelo usado, la versión del prompt y una huella digital del contenido analizado. Ninguna de las tres hubo que comprarla, contratarla ni inventarla. Hubo que advertirla.
Tres de los cuatro «no tenemos» eran, en verdad, «tenemos y no usamos».
Ese es el primer aprendizaje que quiero dejar registrado, porque vale para casi todo el mundo: la mayor parte de lo que se llama «proyecto de IA» en una organización es trabajo de preparación de datos que nadie había hecho todavía. El inventario nos costó algunas horas y cambió el diseño del proyecto entero. El trabajo dejó de ser «construir» y pasó a ser «guardar lo que ya se estaba produciendo y descartando».
Parte 2 — Lo que hicimos, en ocho etapas
Organizamos el trabajo en ocho etapas numeradas, y el orden entre ellas es la parte más importante — más importante que cualquier elección de tecnología.
| Etapa | Qué hace | Situación |
|---|---|---|
| 0 | Monta la regla: un conjunto de preguntas reales para medir si la búsqueda funciona | lista |
| 1 | Guarda el texto de todo documento, página por página | lista |
| 2 | La primera búsqueda única de nuestra historia | lista |
| 4 | El «diccionario» de la base: qué significa cada dato | lista |
| 3 | Vecinos y documentos parecidos (la parte de vectores) | lista |
| 5 | La puerta por la cual entra un asistente de IA | en el aire |
| 6 | El asistente pasa a poder escribir, no solo leer | en el aire |
| 7 | 81 herramientas en los 13 módulos, clasificadas por riesgo | en el aire |
Sí, la etapa 4 viene antes de la 3 en la lista. Invertimos el orden a mitad de camino, por tres razones medidas. Lo explico más adelante.
Las piezas, y por qué todas son libres
Antes de las etapas, la lista de lo que usamos. Viene aquí y no al final porque «¿con qué?» suele ser la primera pregunta — y porque la respuesta es menos impresionante de lo que se espera, que es justamente el punto.
- PostgreSQL 16 — la base donde los datos del Cockpit ya vivían. Todo lo que describo abajo vive dentro de ella. No levantamos ninguna base nueva.
- pgvector — extensión de Postgres que guarda y compara vectores. Es la pieza de «búsqueda por significado».
- unaccent y la búsqueda textual nativa de Postgres — lo que hace que «prestacao» encuentre «prestação».
- poppler, Tesseract 5 con el paquete de portugués, OCRmyPDF y Ghostscript — la lectura de PDF y el reconocimiento de caracteres, todo dentro de nuestra propia máquina.
- Rust, con
axumsirviendo la API ysqlxconversando con la base — es el lenguaje en que está escrito el Cockpit. - calamine, zip y quick-xml — bibliotecas que leen
.docx,.xlsx,.pptxy.odt. Ya estaban declaradas en el proyecto; pasar a usarlas no costó ninguna dependencia nueva. - multilingual-e5-small — el modelo que convierte texto en vectores. Corre local, tiene 384 dimensiones y cabe en una máquina modesta.
- MCP (Model Context Protocol) — el estándar abierto por el cual un asistente de IA conversa con un sistema. Es la etapa 5, y vuelvo a él con calma.
- pgBackRest — la copia de seguridad de la base, que pasó a cubrir toda esa capa nueva sin una línea de configuración adicional, porque vive en Postgres.
Ningún ítem de esa lista es caro, secreto o de acceso restringido. Todo es software libre, con documentación pública, instalable hoy por cualquier organización — y la mayor parte ya estaba en nuestra máquina antes de empezar el proyecto. La escasez, en nuestro campo, no es de tecnología. Es de tiempo para ordenar los datos. Por eso este texto insiste en el orden de las etapas y no en la elección de las piezas.
Etapa 0 — La regla antes de la carrera
La primera etapa tenía dos líneas de código y una tarea que consumió todo el tiempo: montar un conjunto de evaluación. Son 42 preguntas en lenguaje natural, cada una con la respuesta, el documento y la página que la comprueban.
Tres decisiones que parecen detalle y no lo son:
- La regla viene antes de la búsqueda. Quien escribe las preguntas después de ver lo que el sistema encuentra, escribe las preguntas que el sistema acierta. Es autoengaño con apariencia de método.
- Las preguntas se escriben con palabras diferentes de las del documento, a propósito. Eso derrumba el resultado — y es el único modo de que el número signifique «pregunta de gente de verdad».
- La página forma parte del blanco, no solo el documento. Fue esa elección la que reveló, dos etapas después, que nuestro problema real era acertar la página. Una prueba que solo exigiera el documento nunca habría mostrado eso.
Y una decisión de cuidado: ninguna pregunta del conjunto usa dato personal. Nuestro acervo tiene documento de identidad, CPF y filiación, y una parte grande de nuestros participantes es adolescente. El conjunto se montó solo con documentos institucionales — estatuto, actas, balances, políticas. Dos páginas que servirían bien como pregunta fueron descartadas porque traían RG y CPF en el cuerpo. La razón no es solo la privacidad: un archivo de prueba se copia y se pega con mucha más libertad de la que el dato original jamás tuvo.
Etapa 1 — El texto que tirábamos a la basura todos los días
Esta etapa no usa inteligencia artificial de ningún proveedor. Son programas que ya estaban dentro de nuestro sistema: uno lee el texto de dentro del PDF, otro reconoce caracteres cuando la página es foto de papel, otro decide entre los dos.
Con nombres: el pdftotext, de poppler, lo intenta primero, porque un PDF nacido digital ya trae el texto incorporado y leerlo cuesta milisegundos. Solo si la página queda por debajo de un límite de caracteres útiles se rasteriza y va al Tesseract 5 con el paquete de portugués, orquestado por OCRmyPDF. Ese orden — lo barato primero, lo caro solo cuando hace falta — es lo que separó horas de días en el esfuerzo inicial: el motor antiguo mandaba a todo el mundo al reconocimiento de caracteres, incluido el PDF que no lo necesitaba.
Y una precisión honesta, ya que paso el texto entero separando «IA» de «no IA»: el Tesseract 5 es una red neuronal. Cuando digo que esta etapa no usa IA de proveedor, hablo de proveedor — ninguna llamada de API, ninguna clave, ningún byte saliendo — y no de «ninguna red neuronal involucrada».
Ningún PDF sale de la Casa Hacker. Ni para servicio de reconocimiento de texto, ni para servicio de «lectura de documento», bajo ninguna hipótesis. Eso se decidió antes de cualquier línea de código y no se reabrió.
Tres elecciones técnicas que vale traducir:
La unidad es la página. Guardar el documento entero en un campo de texto sería más simple y destruiría el producto. «Encontré el contrato» sin «está en la página 3» no sirve para rendición de cuentas — y la rendición de cuentas es lo que paga la cuenta aquí. Hoy, cuando la búsqueda encuentra algo, abre el PDF en la página exacta.
El documento se identifica por el contenido, no por el nombre. Cada archivo tiene una «huella digital» calculada a partir de lo que contiene — un sha256, la misma suma de verificación que una distribución de Linux publica junto al archivo que descargas. Archivos idénticos tienen la misma huella, así que se leen una sola vez. Descubrimos que cerca del 18% de nuestro acervo son duplicados — el mismo comprobante adjuntado en dos lugares.
La cola es una tabla, no un servicio de mensajería. Documento pendiente es una fila con el estado pendente, y un barrido periódico busca lo que quedó atrás. Podríamos haber levantado un RabbitMQ o un Redis. No lo hicimos: una tabla en una base que ya existe está cubierta por la copia de seguridad que ya existe, sobrevive a un reinicio sin configuración alguna y no se convierte en un servicio más para despertar a alguien de madrugada. Y, sobre todo, el barrido cubre todo por construcción — incluidos los archivos que llegan por caminos que no pasan por la pantalla de envío, como el recolector automático de facturas. Un disparador en el envío cubriría solo a quien avisa; el barrido cubre también a quien no avisa.
Y la parte de la que más me enorgullezco: laguna dicha es laguna; laguna escondida es mentira. Hoy 3.858 documentos están marcados como «formato no soportado» y 94 como «error» — PDF cifrado, archivo corrupto, formato sin lector. Aparecen nombrados en la pantalla, contados. Porque un índice que esconde lo que no consiguió leer produce un «no encontré» que la persona lee como «no existe» — y esa es la peor respuesta posible en un sistema de gestión, porque es idéntica a una respuesta correcta.
Etapa 2 — La primera búsqueda de nuestra historia, y el descubrimiento que nadie esperaba
La parte fácil fue la esperada: búsqueda en portugués, sin exigir acento, respondiendo en milisegundos. Buscar «prestacao de contas» encuentra «prestação de contas».
Esto es la búsqueda textual nativa de PostgreSQL, sin ningún servicio de búsqueda aparte. Son cuatro piezas, todas de fábrica: una configuración de idioma propia, que junta el diccionario de portugués de la base con la extensión unaccent; una columna que se mantiene sola con el texto ya preparado para buscar; un índice GIN encima; y el ts_headline, que devuelve el fragmento con el término resaltado. No instalamos Elasticsearch, no instalamos OpenSearch, no levantamos un segundo servidor. Vuelvo al porqué de esa negativa en las reglas, porque no fue ahorro — fue control de acceso.
El primer resultado honesto fue 2 aciertos en 28 preguntas.
Investigando, encontramos el motivo, y es bonito: el mecanismo de búsqueda de nuestra base de datos no sabe qué es raro. Pesa cuántas veces aparece la palabra dentro del documento e ignora si aparece en todos lados. En nuestro acervo, «casa» aparecía en la mitad de las páginas, «atividade» y «projeto» en casi la mitad — y el sistema daba a esas palabras el mismo peso que a «bolsa incentivo». No era problema de configuración. Era la ausencia de una señal que la documentación no avisa que está ausente.
El nombre de esto, en la literatura de recuperación de información, es frecuencia inversa de documento — el «IDF» que los motores de búsqueda dedicados traen de fábrica desde hace décadas, y que la búsqueda textual de Postgres sencillamente no calcula. Construimos entonces la nuestra: una tabla de rareza de palabras, montada a partir de una función que la propia base ofrece (ts_stat), lista en nueve segundos, hoy con 323.776 raíces que dicen el peso verdadero de cada término. Con eso, 2 en 28 se volvieron 14 en 32.
Y ahí vino la lección mayor. Una pregunta traía la palabra «gitlab», presente en una única página entre 35 mil — el identificador perfecto. El documento correcto aparecía en la posición 155. Motivo: tres palabras medianas sumadas vencían a la palabra única. La suma diluía exactamente la señal más fuerte.
La corrección fue una línea: ordenar primero por la palabra más rara que la página contiene, y usar la suma solo para desempatar. Probamos las variantes obvias antes de elegir esa — sumar el cuadrado de los pesos, duplicar el mayor y sumar el resto, ordenar por cuántos términos cubre la página. Todas medidas, todas peores. Quedaron registradas en el código la que ganó y las tres que perdieron, con el número de cada una. Resultado final, después de tres correcciones de ese tipo:
- documento entre los 10 primeros: de 2 a 19 en 34 preguntas
- página correcta entre las 10 primeras: 14 en 34
- preguntas con error de tipeo: de 3 en 6 a 6 en 6
- tiempo de respuesta: de 177 milisegundos a 11
Una línea de ordenación rindió más que la capa de inteligencia artificial entera. Vuelvo a esto en la etapa 3.
Etapa 4 — El diccionario: la diferencia entre la fecha del hecho y la fecha del sello
Buscar fragmentos responde «dónde está escrito». No responde «cuánto gastamos» ni «cuántos jóvenes atendimos». Esas preguntas salen de consultas a la base — y para acertar esa consulta hay que saber qué significa cada campo.
Fue para eso que construimos un catálogo de datos: la descripción legible de lo que quieren decir cada tabla y cada columna. Se genera automáticamente de la propia base y se verifica a cada cambio de código. Un catálogo mantenido a mano se pudre en semanas y pasa a mentir — lo que es peor que no existir.
La mecánica es modesta y vale copiarla. La base ya sabe describirse a sí misma: Postgres mantiene un inventario de sus propias tablas y columnas (information_schema) y un lugar donde cada una puede llevar un comentario (COMMENT ON, que vive en pg_description). Un programa lee los dos y escribe archivos de catálogo en el repositorio. Lo que transforma eso en documentación viva es el paso siguiente: una prueba de integración continua que rechaza el cambio si el catálogo versionado diverge de la base. Sin esa prueba, es un documento más; con ella, quien toca la base y no describe lo que tocó no consigue integrar. Además de las tablas, el catálogo cubre las rutas de la API y las tareas programadas — y el catálogo de rutas volvió a ser útil de un modo que no habíamos previsto, en la etapa 7.
El campo más importante de ese catálogo es el que separa fecha del hecho de fecha del sello. Déjenme contar el caso concreto, porque lo explica todo:
Existía una columna llamada data_inscricao. Parece la fecha en que la persona se inscribió. Medimos: en 978 de 978 registros, guardaba el día en que el dato fue importado de otro sistema. Una columna hermana, medida después, tenía el 98,9% de los registros concentrados en dos días.
Quien agrupe por esas columnas produce un gráfico de crecimiento que parece correcto, está equivocado y se presenta con convicción — porque la consulta corrió sin ningún error. Ninguna prueba automática detecta eso. Solo el diccionario lo detecta. Reconstruimos la columna a partir de la fuente verdadera, y hoy el catálogo carga la instrucción explícita: no agrupe esto para serie temporal.
El catálogo también mide su propia honestidad: de las 4.807 columnas catalogadas, apenas 232 (4,8%) tienen descripción escrita. El generador imprime ese número en cada vuelta, justamente para que se lo exija y no se lo estime.
Cuando comparamos el acierto de un asistente respondiendo preguntas sobre nuestros datos con y sin el catálogo: 17 de 19 sin, 18 de 19 con. La ganancia en el marcador es pequeña. Pero en 8 de las 19 el catálogo cambió la sustancia de la respuesta incluso cuando el número ya estaba correcto — el asistente pasó a distinguir tres tablas diferentes llamadas «projeto», pasó a saber que una fecha era un sello, pasó a saber que el texto extraído contiene dato personal.
Etapa 3 — La parte «IA» que construimos y dejamos fuera
Esta es la etapa que la mayoría de los proyectos hace primero. La hicimos al final entre las de preparación, y a propósito: sin una línea de base, no hay cómo afirmar que la IA mejoró algo, solo cómo creer que mejoró.
La mecánica, en lenguaje claro: el texto se corta en fragmentos, y cada fragmento se convierte en una lista de números que representa su significado. Fragmentos con sentido parecido quedan próximos. Eso permite buscar por sentido, no por palabra exacta. Hoy tenemos 77.068 fragmentos convertidos.
Con los nombres: el corte en fragmentos es código nuestro, sin biblioteca — párrafos de hasta dos mil caracteres, con un pedazo de solapamiento entre vecinos, y nunca atravesando de un documento a otro. El modelo que convierte fragmento en números es el multilingual-e5-small, de 384 dimensiones, corriendo local en formato ONNX: ningún fragmento fue enviado a proveedor alguno, lo que mantiene en pie la regla de la etapa 1. Los vectores están en pgvector, dentro de la misma base, con un índice HNSW — la estructura que permite encontrar los vecinos más próximos sin compararlos contra todos.
El resultado de la medición fue incómodo y es el resultado más valioso del proyecto:
La capa de inteligencia artificial entera — 44 mil vectores, 167 megabytes, 83 minutos de procesamiento, un componente nuevo en el sistema — rindió un documento más en nuestro conjunto de preguntas. Una línea de ordenación en la búsqueda por palabra rindió dos documentos y tres páginas.
Y peor: la técnica consagrada de combinar las dos búsquedas empeoró el resultado, de 15 a 13. Tiene nombre — fusión recíproca de rangos, o RRF, la receta estándar para casar búsqueda por palabra con búsqueda por vector — y el motivo del fracaso es aritmético, no una opinión: la fórmula suma el inverso de la posición en cada lista, lo que premia al documento mediocre en las dos frente al excelente en una sola. En las preguntas con número de contrato, donde la búsqueda por palabra clavaba el documento en primer lugar, la combinación derribó ese primer lugar. Es una técnica buena, publicada, ampliamente recomendada — y equivocada para nuestro acervo, que está lleno de identificadores. Solo la medición podía decirlo.
Entonces mantuvimos los vectores cargados y fuera de la búsqueda. Hoy sirven a tres cosas útiles, todas medidas:
- Documentos parecidos. Para cada documento, los ocho más próximos del acervo. Un término de donación señaló como vecino otro término del mismo modelo, en una décima de segundo.
- Casi duplicados. 35.550 pares. Sirve para limpieza de acervo: dos certificados del mismo proveedor, dos envíos del mismo comprobante.
- Triaje. Un documento sin clasificación recibe sugerencia de tipo por sus vecinos, para que una persona confirme con un clic.
Un efecto colateral que se volvió tarea propia: la pantalla de casi duplicados tardaba 25,8 segundos. Faltaba un índice en la base por la columna de la huella digital — cuatro líneas de migración. Pasó a 0,36 segundos. Una capa nueva sobre un sistema antiguo revela lo que estaba durmiendo.
Etapas 5, 6 y 7 — El asistente entra por la puerta del frente
Aquí la IA finalmente entra, y la pregunta que nos guio fue: ¿cómo puede un asistente trabajar con nuestros datos sin saltarse ninguna de nuestras reglas de acceso?
Esa puerta tiene nombre: MCP, el Model Context Protocol. Es un estándar abierto, publicado por Anthropic a finales de 2024 y hoy hablado por más de un fabricante de asistentes, que define cómo una IA descubre y usa las herramientas de un sistema externo. Antes de él, conectar un asistente a un sistema significaba escribir una integración a medida para cada asistente. Con él, el sistema publica sus herramientas una vez, y cualquier cliente que hable el protocolo las encuentra solo.
Nuestro servidor MCP está construido y en el aire. No es un plan ni un prototipo: son 86 herramientas publicadas sobre los 13 módulos del Cockpit, y la prueba se hizo contra el sistema en producción — el cliente pide la lista de herramientas y recibe las 86; ejecuta una lectura y recibe la misma respuesta que daría la pantalla; pide un ensayo de escritura y recibe el efecto previsto sin que nada ocurra; y, cuando pide lo que su alcance no cubre, recibe un 403 con el nombre exacto del permiso que faltó.
Y es esto lo que da sentido a las siete etapas anteriores: el acervo dejó de ser un depósito y pasó a ser alcanzable. Los 24.549 documentos, las 60.702 páginas de texto, las 53 columnas de prosa escritas por nuestro equipo, el catálogo que dice lo que significa cada campo y los 13 módulos del sistema están, hoy, al alcance de un asistente de IA — por la misma puerta y con los mismos permisos que tiene una persona. Una educadora puede preguntar en portugués dónde está la cláusula de un contrato y recibir el documento y la página. Quien se ocupa de la rendición de cuentas pide el comprobante de un pago sin abrir ninguna carpeta. Y nada de eso exigió abrir la base de datos a la IA, mandar un documento hacia fuera ni conceder a nadie un permiso que ya no tuviera.
Para una organización de nuestro tamaño, esa es la parte que no sabía si conseguiríamos. Un servidor MCP en producción no es lo que se espera de una organización de la sociedad civil de la periferia, corriendo en ocho núcleos de procesamiento, sin equipo de plataforma. Lo conseguimos — y lo conseguimos porque no empezamos por aquí. Hizo falta tener texto guardado (etapa 1), una búsqueda que funcionara (etapa 2), un catálogo que explicara los datos (etapa 4) y vectores medidos (etapa 3) para que valiera la pena abrir la puerta de la etapa 5. Quien abre esa puerta primero le entrega al asistente un acervo que no consigue leer, sobre una base que no sabe interpretar. La puerta es la parte fácil. Lo que la vuelve una puerta útil es todo lo que viene antes.
Lo que permitió llegar hasta ahí sin romper ninguna regla de acceso tiene tres partes.
Pocas herramientas nombradas, nunca acceso libre a la base. Comenzamos con tres: buscar documentos, leer un documento por página, consultar el catálogo. No treinta. La consulta libre a la base está prohibida por escrito. Un asistente con acceso libre se equivoca más y se equivoca en silencio.
Inicio de sesión de verdad, no contraseña pegada en un archivo. La persona hace clic en «conectar» en su asistente, es llevada al Cockpit, inicia sesión como lo haría en la pantalla, ve exactamente lo que se está pidiendo y autoriza. El acceso concedido es obligatoriamente menor o igual al que ya tiene en el sistema. Nadie gana permisos por conectar un asistente.
Esto es OAuth 2.1 — el mismo estándar del «entrar con» que todo el mundo ya ha usado, y que la especificación del MCP prevé justamente para servidores remotos como el nuestro. La alternativa sería que cada persona generara un token y lo pegara en un archivo de configuración, y la razón de rechazarlo es prosaica: un token pegado acaba en una conversación, en un historial, en una captura de pantalla. Pero hay una consecuencia mayor, de alcance. Como conectar se volvió un clic, el servidor pudo distribuirse a la casa entera como un plugin de Claude, y no solo a quien sabe editar un archivo de configuración. Eso cambia quién es el público — y es exactamente por eso que el enmascaramiento de datos personales y la expectativa calibrada, más adelante, dejan de ser un refinamiento y se vuelven obligación. Una respuesta equivocada con convicción golpea de lleno a quien no tiene repertorio para desconfiar de ella.
Cada acción clasificada por cuánto duele. Hoy son 86 herramientas y 230 acciones en los 13 módulos, y cada una fue clasificada abriendo el código, una por una — dos veces, por equipos independientes, porque la primera vuelta dejó pasar seis casos:
- 118 acciones reversibles — se ejecutan y quedan registradas. Crear un orden del día, dar de alta a un miembro.
- 29 acciones con efecto hacia fuera — sin confirmación explícita, el sistema devuelve lo que iría a ocurrir y se detiene. Mandar un correo a alguien, enviar un contrato para firma, tocar una cuenta corporativa.
- 14 acciones que mueven dinero o patrimonio — exigen un ensayo previo registrado y confirmación humana. Liquidar un título, revertir un asiento, cambiar quién es responsable de un equipo.
Podríamos haber dejado las rojas fuera. Preferimos lo contrario: entran, obligadas a mostrar antes exactamente lo que van a hacer. Sacar la acción de la mesa esconde el riesgo; obligarla a explicarse antes vuelve el riesgo auditable.
Hay una decisión de arquitectura que quizá sea la parte más reaprovechable de todo esto: las herramientas no conversan con la base — llaman a las mismas rutas que llama la pantalla. Cuando alguien le pide al asistente que registre a un miembro, el pedido se despacha internamente a exactamente la ruta que usaría el formulario del Cockpit, llevando la identidad de quien autorizó. La consecuencia es que ninguna validación, ninguna verificación de permiso y ningún registro de auditoría hubo que reescribirlos para la IA: todo corre por construcción, porque es el mismo código. La alternativa — reimplementar las reglas del lado del asistente — crea una segunda fuente de verdad, que se desbarata el día en que alguien cambia una regla en un solo lugar. Es la misma lección de la regla 4, justo abajo, aplicada de nuevo.
Y tres cuidados que existen por una diferencia simple: una persona hace clic una vez; un asistente repite la llamada cuando la red falla.
- Clave de idempotencia. Toda escritura lleva un identificador de la operación. Repetir la llamada devuelve el resultado de la primera — no crea una segunda factura a pagar.
- Ensayo antes de la acción. Toda escritura sabe responder «qué pasaría si hiciera esto», sin hacerlo. En las acciones rojas el ensayo no es opcional: sin uno registrado antes, la ejecución se rechaza.
- Linaje. Cada escritura graba quién autorizó, qué agente ejecutó, cuándo, con qué datos y con qué resultado. Acción sin rastro no existe en el diseño.
Fue aquí donde el catálogo de la etapa 4 cobró su propia inversión de un modo que no habíamos previsto. Las 230 acciones viven en un registro que apunta, una a una, a la ruta que cada una llama — y una prueba de integración continua compara ese registro con el catálogo de rutas a cada cambio. Una ruta renombrada dejó de ser algo que rompe el asistente en producción y pasó a ser algo que rechaza el cambio antes de que entre. La primera ejecución de esa prueba encontró seis rutas que el registro citaba y que ya no existían — y, detrás de ellas, un defecto en el propio generador del catálogo, que pasó a tratarse como defecto registrado y no como curiosidad.
Las cinco reglas que no negociamos
Si este texto sirve para algo fuera de aquí, espero que sea por esta lista.
- Ningún documento sale de casa. Toda lectura de PDF y todo reconocimiento de texto ocurren dentro de nuestra propia infraestructura. Asumimos el costo: el techo de calidad pasa a ser el de nuestra herramienta, sin plan B para digitalización mala.
- El permiso es del adjunto, nunca del contenido. El mismo archivo puede estar adjuntado en contextos de dueños diferentes. Si la búsqueda respondiera por la huella digital del archivo, quien tiene acceso a un adjunto leería el texto de otro contexto. La búsqueda devuelve el adjunto, y la autorización se resuelve antes de llegar al texto.
- Enmascaramiento en la salida, nunca en el almacenamiento. Cuando un fragmento va a un servicio externo, CPF, CNPJ, correo electrónico y teléfono son sustituidos, y queda registrado cuántos datos salieron. Guardar una segunda copia «limpia» sería crear dos fuentes de verdad — y un texto enmascarado en la base destruye la búsqueda incluso para quien tiene permiso.
- La búsqueda hereda el control de acceso, no lo reimplementa. Esa fue la razón de mantener la búsqueda por significado dentro de nuestra propia base de datos, en vez de contratar un servicio separado. Un índice que vive fuera no sabe quién puede ver qué: o copia nuestras reglas de permiso — y se desbarata el día en que alguien cambia una regla en un solo lugar — o filtra jurídico, RR. HH. y denuncias. Llegamos a considerar una base de vectores dedicada, y Qdrant era el candidato; la rechazamos por esa razón, no por rendimiento. Dentro de pgvector, filtrar por lo que la persona puede ver es un
JOIN; fuera de él, es una segunda copia de nuestro modelo de permisos. Por el mismo motivo no levantamos Elasticsearch para la búsqueda por palabra. Y dejamos escrito lo que nos haría cambiar de idea: pasar de cinco millones de fragmentos, o que la búsqueda por vecindad tarde más de 300 milisegundos, o que surja una necesidad real de aislar acervos en índices separados. Una decisión sin criterio de revisión es terquedad con fecha marcada. - Toda respuesta cita la página. Sin cita verificable, la respuesta es palabra de la IA. Y la palabra de la IA no le rinde cuentas a ningún financiador.
Lo que tenemos hoy, en números
Todo medido el día en que este texto fue escrito, contra el sistema en producción:
- 30.099 adjuntos, 24.549 contenidos distintos, 21.729 PDF
- 60.702 páginas de texto guardadas, 171,7 millones de caracteres
- 4.326 páginas que exigieron reconocimiento de caracteres
- 5.333 textos venidos de campos escritos por gente del equipo
- 323.776 palabras en la tabla de rareza
- 77.068 fragmentos convertidos en vectores
- 44.164 vectores de 384 dimensiones, generados por un modelo que corre en nuestra máquina
- 1.204 rutas de API catalogadas — 837 combinaciones de ruta y método sirven para leer, 1.392 para escribir
- 86 herramientas de IA publicadas por el MCP, 230 acciones clasificadas
- y el servidor donde todo esto corre tiene 8 núcleos de procesamiento
Ese último número no es una anécdota, es el principal hecho de ingeniería de este proyecto. No somos una empresa de tecnología con nube infinita. La movilización inicial de lectura de documentos corrió en una máquina alquilada por horas y destruida al final, con permiso apenas de lectura, sin abrir un solo puerto nuevo en producción. Después de eso, el procesamiento diario corre en producción con un único trabajador y techo por pasada.
Y una prueba de que el diseño aguanta: entre la primera medición y hoy, nuestro acervo más que se duplicó — porque entró la exportación integral de un sistema contable que vamos a apagar. El diseño absorbió eso sin ninguna alteración. Un proceso que solo funciona en el volumen con el que fue construido no es un proceso.
Parte 3 — Ahora sí: las preguntas que queremos hacer
Después de reunir toda la base de datos, comenzamos a preguntarnos: ¿qué puede salir de aquí? ¿Qué respuestas podrían revelarnos el contexto y el cruce seguro de esas informaciones?
Especulamos bastante. Una de las ideas fue pensar en cómo la inteligencia artificial podría ayudarnos a hacer un análisis predictivo a partir de la trayectoria de una joven que entra en uno de nuestros programas — es decir, usar el historial de quienes ya pasaron por aquí para estimar lo que puede ocurrirle a quien está llegando. Mirando la historia de la Casa Hacker y a los jóvenes que ya abandonaron, ¿qué podrían revelarnos esos datos, tratados con todo el cuidado, sobre esta nueva joven? ¿Cómo podría eso ayudarnos a acoger mejor a alguien con mayor probabilidad de abandono?
Traigo algunos ejemplos concretos de lo que nos gustaría conseguir ver:
- ¿Los miembros de una región específica se atrasan más por problemas urbanísticos del territorio — calles sin asfalto, inundaciones recurrentes en día de lluvia?
- ¿Los miembros de un determinado barrio presentan más problemas respiratorios por falta de infraestructura? ¿Y podríamos, a partir de eso, hacer un seguimiento más cercano con las familias antes de que eso se convierta en falta recurrente y después en abandono?
- ¿Los jóvenes que pasan por cambios frecuentes de domicilio tienen mayor riesgo de abandono en los primeros meses?
- ¿Existe un patrón de desenganche silencioso — una asistencia que va cayendo poco a poco, sin una falta única que llame la atención, pero visible a lo largo de una serie histórica?
- ¿Los horarios de mayor ausencia coinciden con la distancia hasta el transporte público de determinadas familias?
- ¿Hay meses del año — período de matrícula escolar, temporada de trabajo informal de los responsables — en que el abandono se vuelve más probable?
- Mirando a hermanos o parientes que ya pasaron por la Casa Hacker, ¿existe un patrón familiar que pudiéramos anticipar?
Y hay un segundo grupo de preguntas, más ambiciosas, que solo se responden cruzando nuestros datos con el boletín escolar y con bases públicas:
- ¿Los jóvenes con caída de desempeño en una asignatura específica en los dos meses anteriores al ingreso en un programa de tecnología abandonan más temprano? Eso permitiría refuerzo pedagógico dirigido antes de que el abandono aparezca en nuestra asistencia.
- Cruzando renta familiar declarada con asistencia, ¿es posible identificar si los jóvenes de familias en mayor vulnerabilidad faltan más en períodos específicos del mes — indicando el momento correcto para una beca-auxilio o un vale de transporte?
- ¿Los jóvenes con historial de repetición necesitan un itinerario de acogida pedagógica diferente ya en el primer mes?
- Cruzar composición familiar con faltas puede revelar si responsabilidades de cuidado doméstico — que recaen sobre las chicas con mucha más frecuencia — explican ausencias que, a primera vista, parecerían desinterés. Esa hipótesis, sola, justificaría el esfuerzo.
- ¿Los jóvenes de escuelas con alta rotación de profesores (dato público del censo escolar) tienen más dificultad de adaptación, sugiriendo apoyo extra de nivelación?
- ¿Los jóvenes que viven más lejos, incluso con boletín estable, abandonan más en época de aumento de tarifa de transporte — algo que solo aparece cruzando dato geográfico con calendario económico?
- Y, entre quienes concluyeron los programas con éxito, ¿existe un perfil recurrente? ¿Un mapa de factores protectores, y no solo de riesgo?
Confieso que creo que es exactamente en ese lugar donde la inteligencia artificial debería actuar: mostrándonos, a partir de la historia y de los datos acumulados, cómo acoger mejor a cada persona, e identificando patrones que nuestra capacidad humana, sola, difícilmente vería.
No estamos esperando que la IA haga cosas triviales por nosotros, como leer y responder nuestros correos — eso no nos interesa. Lo que nos interesa es: ¿cómo ir más allá? ¿Cómo recibir mejor a las personas? ¿Cómo identificar riesgos antes de que ocurran — no para excluir a nadie, sino para acoger con más cuidado? Si la inteligencia artificial no sirve para eso en algún momento, siento que habremos fallado.
Lo que la regla dice de nuestra propia ambición
Si este proyecto me enseñó una cosa, fue a medir antes de afirmar. Entonces apliqué la misma regla a mi propia ambición, y el resultado merece estar publicado.
Lo que ya tenemos:
- 1.210 miembros registrados, 2.756 inscripciones en 216 actividades
- 24.309 registros de asistencia en 2.083 encuentros, de junio de 2022 hasta hoy
- 928 miembros con asistencia registrada, y 733 de ellos con cinco o más registros — o sea, con serie suficiente para dibujar una curva
- 3.509 registros de acompañamiento individual
- dirección utilizable en 921 de los 1.210 miembros (76%), lo que vuelve posible el cruce territorial para tres de cada cuatro
El límite que nos pusimos a nosotros mismos
Necesita estar escrito, porque es sobre niños, niñas y adolescentes.
De nuestros miembros con fecha de nacimiento registrada, 376 son menores de 18 años. Atribuir una «nota de riesgo de abandono» a un adolescente no es un acto neutro, y un sistema que haga eso sin trabas se vuelve, muy rápido, una máquina de etiquetar a jóvenes de periferia. Ya vimos esa película en crédito, en seguridad pública y en educación.
Nuestras trabas, entonces:
- La previsión nunca se vuelve nota del joven. Se vuelve, como máximo, una invitación a una conversación y una señal para el equipo pedagógico. Nunca criterio de entrada, de permanencia o de selección.
- Nunca para excluir; siempre para acoger. Si algún día un número de este sistema se usa para sacar a alguien de un programa, el sistema falló y debe ser apagado.
- La persona decide, siempre. La máquina prepara, evidencia y cita. Quien decide es la educadora que conoce a aquella familia. Eso no es diplomacia — es el diseño técnico: cada acción relevante del asistente exige confirmación humana.
- Factor protector, no solo factor de riesgo. La pregunta «¿qué da resultado con quien concluye?» es más útil, y menos peligrosa, que «¿quién va a desistir?».
- Dato de salud solo con autorización explícita, y dato de responsable legal con base legal clara. Nos rige la LGPD y tratamos eso como restricción de diseño, no como cláusula al pie.
- Ningún documento y ningún dato personal identificable va a un servicio externo sin pasar por el enmascaramiento descrito arriba.
Comunicar mejor con quien invierte
Hay un punto tan importante como los anteriores: cómo la inteligencia artificial puede ayudarnos a comunicarnos mejor con nuestros financiadores, a generar datos con más calidad y más auditables, a dar más transparencia sobre nuestros gastos, demostrando de forma más inteligente cómo operamos en el día a día para quien invierte con nosotros.
Esa parte es la que ya cambió en la práctica, y cambió porque la preparación se hizo en el orden correcto. La casi totalidad de nuestros ingresos es recurso con destino marcado — proyectos de incentivo fiscal, donaciones con cargo, convocatorias — y cada gasto se comprueba documento por documento. Lo que era arqueología en carpetas hoy es una búsqueda que devuelve el documento y la página, en milisegundos, respetando quién puede ver qué. El comprobante duplicado aparece como par, y no como descubrimiento accidental en la revisión de la víspera del plazo.
Y tiene una consecuencia económica directa: hasta 2027 planeamos apagar siete plataformas propietarias que hoy pagamos por suscripción. Cambiamos licencia recurrente y contrato de tratamiento de datos frágil por acervo propio, auditable y bajo nuestra responsabilidad.
Por qué estamos contando esto
Porque el método es la parte que sirve a otras organizaciones, y es el resultado de largo plazo que escribimos en nuestra propia planificación: método de preparación de datos documentado y replicable por otras organizaciones de la sociedad civil.
Ninguna organización de nuestro campo tiene nube infinita. Casi todas tienen un acervo grande y un equipo pequeño. Lo que se transfiere de aquí no es código — es el orden de las etapas y el hábito de medir antes de decidir. Y vale insistir en un punto que la lista de piezas de más arriba ya decía sin alarde: no hay en esta arquitectura un solo componente pago, propietario o de acceso restringido. Postgres, pgvector, unaccent, poppler, Tesseract, OCRmyPDF, un modelo de embeddings abierto y un protocolo abierto. Lo que costó no fue licencia — fue decidir el orden, escribir la regla y aceptar lo que respondió. En ocho etapas, seis hipótesis plausibles nuestras fueron desmentidas por la medición: aumentar la resolución del escaneo (empeora), limpiar la imagen antes de leer (destruye el 28% de los caracteres), combinar las dos búsquedas (empeora), mostrar una página por documento (empeora la precisión de página). Cada refutación está escrita dentro del código, con el número, en el lugar exacto donde alguien intentaría de nuevo.
El valor más barato que produce una medición no es descubrir qué hacer. Es impedir tres cambios que parecían mejoras.
Decimos que las periferias no son lugar de espera, son lugar de comienzo. Eso vale también para nuestra relación con la tecnología: no estamos esperando que una gran solución de inteligencia artificial llegue de afuera lista para nuestra realidad. El vuelco no viene de afuera. Estamos arreglando la casa para que, cuando sirva, sirva de verdad — para acoger gente, y no para darnos respuestas bonitas sobre datos que no entendíamos.
Esos son algunos de los desafíos que creo que deben guiarnos como propósito.
El relato técnico completo de este trabajo, con todas las mediciones, decisiones de arquitectura y el glosario de los términos usados aquí, está publicado como whitepaper. El conjunto de 42 preguntas que usamos como regla está versionado y puede ser ejecutado por cualquier persona — fue hecho a propósito para que otra organización pueda repetir la medición en su propio acervo.