
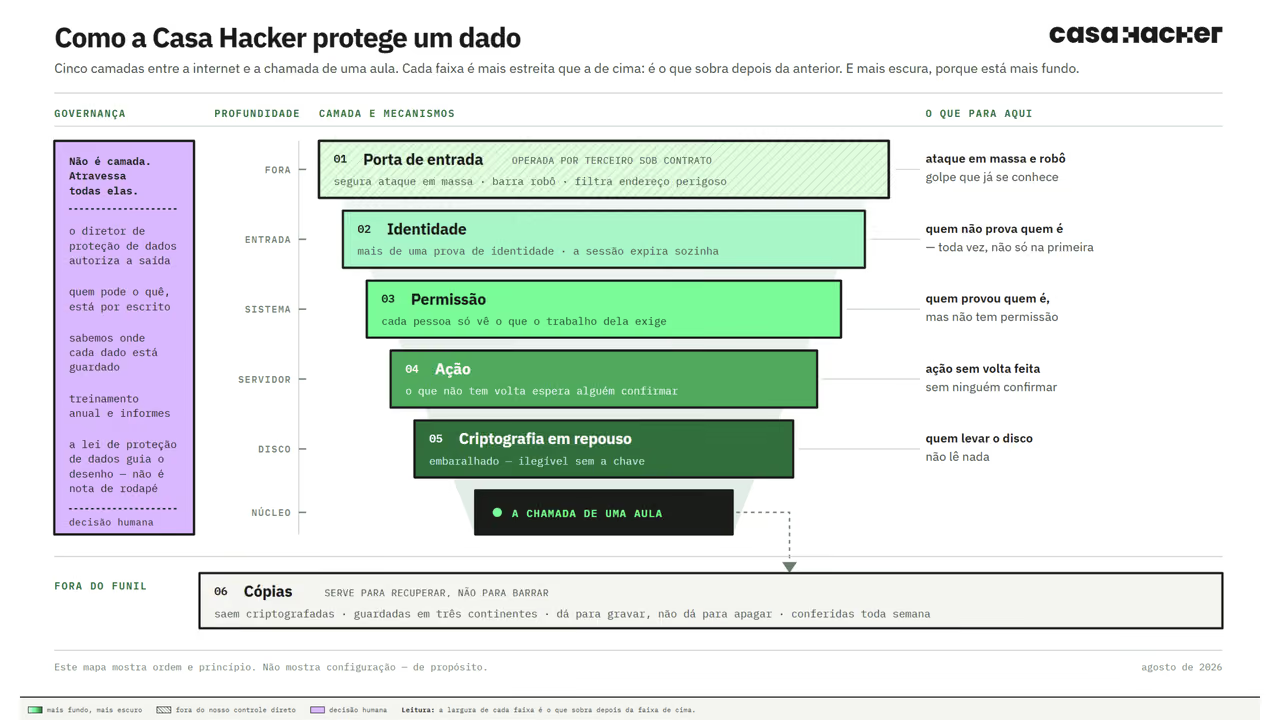
En los últimos meses, Casa Hacker hizo un trabajo de endurecimiento de nuestras plataformas. Hardening, en la jerga. En la práctica: apretar lo que estaba flojo y cerrar lo que estaba abierto por costumbre.
Fue de punta a punta — desde los servidores que usamos todos los días hasta formación del equipo y cambios considerables en los sistemas. No fue mantenimiento. Fue condición.
Condición porque queríamos avanzar con nuestros planes de inteligencia artificial y computación cognitiva, y no se podía hacer eso sobre una base que nadie había revisado. Una plataforma de IA construida sobre cimientos flojos no es una plataforma de IA. Es un riesgo con una interfaz bonita.
Así que el orden fue ese: primero la casa, después lo que queremos poner dentro de ella. Seguridad y privacidad desde el diseño — no como una capa aplicada al final, porque una capa aplicada al final es un parche, y los parches se despegan.
Casa Hacker defiende la protección de datos desde hace años. Sobre todo la del titular: la persona a quien pertenece el dato. Eso no es una postura de comunicación. Es la forma en que fue concebida la Ley General de Protección de Datos de Brasil, y estamos de acuerdo con ella.
Y si nos parece que la ley importa lo suficiente como para defenderla hacia afuera, lo mínimo es implementarla aquí adentro. Etapa por etapa. Incluidas las etapas aburridas, las que nadie ve y que no dan para publicación ninguna.
Qué quiere decir “cifrado” aquí
Toda conversación entre el mundo de afuera y Casa Hacker pasa cifrada, por una sola entrada. No hay segunda puerta, ni atajo para un sistema en particular, ni excepción “solo por ahora” — que es justamente el tipo de excepción que se queda.
Pasada la puerta, nuestros sistemas conversan entre sí sin tocar internet. Hablan dentro de la propia máquina.
Y está la otra mitad, la que casi nadie pregunta: el dato en reposo. Nuestras bases de datos y los archivos sensibles viven dentro de un volumen cifrado. Si alguien se llevara el disco, se llevaría ruido.
Las copias
Lo que guardamos se copia fuera de Brasil todos los días: tres países, en tres continentes. Cifrado antes de salir — el nombre del archivo y el contenido. Quien lo interceptara no sabría ni cómo se llama el archivo.
Dos decisiones ahí adentro merecen decirse, porque las dos cuestan.
El servidor cifra sus propias copias y no consigue leerlas de vuelta. La clave no vive en él. Quien comprometa el servidor no lee el histórico. El precio es que pasamos a depender de una custodia de clave guardada fuera de allí: si se pierde la clave, se pierde el respaldo. Asumimos ese riesgo con los ojos abiertos, porque el otro riesgo es peor.
Las copias se pueden escribir, nunca borrar. Alguien con control total del servidor no consigue borrar lo que ya fue guardado. Esa es la diferencia entre tener respaldo y tener un respaldo que sobrevive exactamente al día en que uno lo necesita.
Guardar no basta. Hay que ensayar la vuelta.
Un respaldo que nunca fue probado es fe, no es respaldo.
Cada semana un proceso automático llega hasta una de las copias más distantes, la descarga de verdad — por internet, como lo haría en un día malo — y verifica que el paquete esté íntegro y que abra con la clave correcta.
Siendo exactos sobre lo que ese ensayo prueba y lo que no prueba: prueba que la copia existe fuera de aquí, que llega entera y que es legible para quien tiene la clave. No es una restauración completa del sistema en pie. Esa sigue siendo un ejercicio con mano humana. Lo escribimos porque “tenemos respaldo probado” es una frase que muchas organizaciones usan cuando lo que probaron fue el código de salida de un script.
Confianza cero — incluso en nosotros
El nombre de esto es zero trust, confianza cero. No es invención nuestra: el concepto nació en una consultora estadounidense en 2010, se volvió norma técnica publicada por el instituto de estándares de Estados Unidos y hoy es práctica corriente de seguridad. Lo que dice es simple e incómodo — estar adentro no es una credencial.
En la práctica, aquí: todo acceso a datos queda registrado, y quien accede necesita seguir probando que es quien dice ser. No es iniciar sesión una vez por la mañana y tener libre tránsito hasta la noche. Es identificación cada vez, con más de un factor — y uno de esos factores pasa por una plataforma que solo existe para gente de Casa Hacker.
Ese último detalle es lo que más reduce el riesgo que no es técnico. La mayor parte de los ataques exitosos hoy no fuerzan nada: convencen a alguien. Un factor que no puede pedirse por teléfono, ni pegarse en un chat, ni reproducirlo quien imita bien una credencial saca a la ingeniería social del juego en buena parte de los casos.
Quien sostiene esto en nuestro borde es la plataforma de acceso de Cloudflare. Nuestros paneles administrativos internos no están protegidos solo por la contraseña de la propia aplicación: están detrás de una verificación de identidad que ocurre antes de que la solicitud llegue al sistema. Quien no pasa esa verificación nunca conversa con la aplicación — ni siquiera se entera del intento.
La identidad viene de nuestro directorio corporativo, no de un registro paralelo. Eso importa más de lo que parece: cuando alguien sale de la organización, apagar la cuenta corporativa cierra el acceso a todo de una vez. No existe esa lista de sistemas en los que la persona “también tenía usuario” — la lista que nadie encuentra justamente el día en que la necesita.
La sesión expira. Acceso concedido no es acceso permanente. Y las cuentas de máquina — las que un programa usa para hablar con otro — tienen regla propia, separada de la de las personas. Tratar a un programa y a una persona con la misma vara es como se pierde el control de los dos.
El equipo también entra en la cuenta. Los dispositivos del equipo se inscriben con un perfil definido por la organización, y ese perfil no es negociable en la máquina de la persona: no se puede apagar la protección porque ese día molestó. Seguridad que el propio usuario desactiva en dos clics es una sugerencia, no un control.
Cada persona ve lo que su trabajo exige
Nadie aquí tiene acceso a todo. Cada persona tiene un rol, y el rol define lo que alcanza — el nombre técnico es segregación de funciones, o control de acceso basado en roles.
Es molesto. Molesto de verdad: genera pedidos de acceso, genera espera, genera “no consigo abrir esto”. Elegimos lo molesto. El acceso amplio es cómodo hasta el día en que una sola cuenta comprometida se vuelve la organización entera.
El borde: el Proyecto Galileo
Hay algo que hace falta decir sin falsa modestia: a organizaciones como la nuestra las atacan. No por casualidad, y no porque tengamos dinero — sino por lo que decimos, por a quién atendemos y por dónde estamos. La sociedad civil, el periodismo, los derechos humanos y la educación en territorio periférico entran en la mira con regularidad. Y casi ninguna organización de ese campo tiene presupuesto para seguridad de porte empresarial.
El Proyecto Galileo, de Cloudflare, existe justamente por ese desencuentro. Creado en 2014, otorga gratuitamente protección de nivel empresarial a organizaciones de interés público en situación de vulnerabilidad. Casa Hacker forma parte de él.
En la práctica, eso cambió el diseño de nuestro borde — la frontera entre internet y nosotros. Vale explicar qué hace cada pieza, porque “estamos protegidos por Cloudflare” no quiere decir nada por sí solo.
El ataque no llega. Contra un ataque de denegación de servicio — el que tumba un sitio por volumen, no por falla —, la defensa no es aguantar el golpe. Es que el golpe no llegue. El tráfico malicioso se absorbe en una red distribuida por el mundo, con una capacidad que nosotros jamás tendríamos ni tendría sentido intentar tener. Nuestro servidor no se vuelve más fuerte: se sale del camino.
Solo pasa lo legítimo. Toda solicitud que llega se inspecciona antes de ser reenviada. Una solicitud que carga un patrón de ataque conocido muere en el borde, no en nuestro servidor. Lo que sostiene la máquina no es nuestra capacidad de resistir una solicitud maliciosa — es que nunca fue entregada.
El DNS también es una puerta — y abre para los dos lados. Casi todo el mundo piensa la seguridad como quien vigila la entrada. Pero un equipo comprometido no es peligroso porque alguien entre por él: es peligroso porque intenta salir, buscando el servidor de quien lo infectó. Usamos filtrado de DNS monitoreado justamente ahí. Antes de que exista cualquier conexión, en el momento en que un nombre se vuelve dirección, los destinos reconocidamente maliciosos quedan bloqueados. Es la defensa más barata y más subestimada que existe: actúa antes de que el ataque tenga a dónde llamar.
La política anda con la persona, no con la oficina. Los equipos del equipo ejecutan el cliente de la plataforma de acceso de Cloudflare. Eso significa que las mismas reglas valen en la oficina, en casa, en un coworking o en el celular en el autobús. Es lo opuesto del modelo antiguo, en el que la red de la oficina era “el lugar seguro” y todo lo demás era excepción — un modelo que murió, y que muchas organizaciones todavía fingen que está vivo.
Un cortafuegos de aplicación que auditamos todos los días. Un filtro de seguridad tiene un efecto colateral clásico: bloquear a gente de verdad. Un formulario que no se envía, un adjunto que falla, una persona que desiste. Y nadie se entera, porque quien fue bloqueado por error no abre un ticket — se va.
Por eso nuestro filtro no está solo encendido: está auditado. Todos los días un proceso automático examina lo que fue bloqueado en las últimas horas y separa lo que era ataque de lo que pudo haber sido alguien legítimo, y el resultado cae en un canal interno donde el equipo lo ve. Si ese monitor enmudece, eso cuenta como incidente — un monitor callado es indistinguible de “está todo bien”.
Esa distinción es la diferencia entre seguridad y obstrucción. Bloquear es fácil. Saber a quién bloqueaste por error es el trabajo.
Anti-robot sin peaje para quien es gente. Nuestras pantallas públicas — incluido el canal de denuncias — usan una verificación anti-robot que funciona sin rompecabezas, sin “haz clic en todos los semáforos” y sin rastrear a la persona por internet. Esto no es comodidad: un canal de denuncias tiene que resistir la inundación automatizada y, al mismo tiempo, no puede cobrarle a quien denuncia el precio de ser identificado. Conciliar las dos cosas era difícil hasta hace poco.
Dos piezas discretas cierran el bloque. Nuestro dominio está firmado criptográficamente, lo que impide que alguien convenza a internet de que la dirección de Casa Hacker es otro servidor. Y la conexión solo ocurre en versiones modernas del protocolo de cifrado, con el propio borde verificando el certificado de nuestro servidor antes de hablar con él. Nadie se mete en medio de esa conversación.
Nótese que esta última pieza es la misma idea de la sección anterior. La confianza cero no es un producto que se compra: es la decisión de no tener un lugar privilegiado. El borde es donde esa decisión se vuelve configuración.
No ahorramos en seguridad
Esta es una elección presupuestaria, y aparece en las herramientas.
Nuestra infraestructura corre en Red Hat Enterprise Linux 10. No es el sistema más barato de operar, y no es el más fácil. Es el que tiene ciclo de vida largo y previsible, corrección de seguridad con plazo y responsable, política criptográfica gestionada de forma central y un ecosistema de cumplimiento que permite auditar la máquina contra un estándar externo en lugar de contra nuestra propia opinión.
Y buena parte de lo que desarrollamos — incluido el sistema donde viven los datos sensibles de la organización — está escrito en Rust. La razón es directa y no es moda: una porción enorme de las fallas graves de seguridad de la historia del software viene de errores de manejo de memoria, y Rust fue diseñado para volver esa clase entera de error imposible de compilar. Es seguridad que no depende de que quien escribió estuviera atento ese día.
Cuesta más caro en tiempo de desarrollo. Es un lenguaje exigente, que discute con quien escribe. Aceptamos esa discusión, porque ocurre antes de que el código llegue a producción — y no después, con datos de gente real de por medio.
Que una organización social elija la herramienta más robusta en vez de la más barata es una decisión política sobre a quién pertenecen esos datos.
Software seguro desde donde nace
La seguridad de plataforma no empieza en el servidor. Empieza en cómo el software llega hasta él.
Aquí, tres principios gobiernan eso.
Por defecto, no corre nada. La configuración de nuestro servidor rechaza cualquier imagen de aplicación por principio. Cada origen de software necesita estar explícitamente autorizado para poder ejecutarse, y las piezas del sistema operativo solo corren si su firma criptográfica coincide con la clave del fabricante. La postura por defecto es “no”, y cada “sí” fue una decisión registrada.
Versión exacta, no etiqueta. Las aplicaciones corren en una versión identificada por la huella digital del contenido, no por un apodo como “la más reciente”. El apodo cambia bajo los pies; la huella digital no. Eso significa que sabemos exactamente qué está corriendo, y que una actualización es siempre un acto deliberado — nunca una sorpresa que llegó de madrugada.
Nada entra sin revisión. Un cambio de código pasa por propuesta revisada y por verificación automática antes de volverse producción.
Cómo sabemos que estamos seguros: midiendo
Esta es la parte que separa la seguridad del discurso sobre seguridad.
Existe un estándar internacional de configuración segura para servidores, mantenido por una organización independiente, el CIS. Es una lista larga y aburrida de cientos de verificaciones objetivas — el tipo de documento que nadie lee por placer y que justamente por eso sirve: no tiene opinión sobre nosotros.
Auditamos nuestra máquina contra ese estándar, en el nivel recomendado para servidor de producción, antes de empezar el trabajo. Después volvimos a auditar en cada etapa. Hoy nuestro cumplimiento está en un nivel alto — bastante por encima de lo que encontramos en la primera medición, y por encima de lo que es común ver en infraestructura de organizaciones de nuestro porte.
Lo que importa aquí no es la nota. Son otras dos cosas.
La primera: la regla vino antes del trabajo. La primera medición se hizo para saber dónde estábamos, no para probar que estábamos bien. Sin esa línea de base, “mejoramos mucho la seguridad” sería una frase sin nada detrás.
La segunda: no estamos en el 100%, y no pretendemos fingir que sí. Parte de lo que falta es desvío deliberado, documentado con su razón — configuraciones que el estándar recomienda y que romperían el funcionamiento de la base de datos o de las aplicaciones, y donde elegimos conscientemente el funcionamiento, registrando la elección. Seguridad sin servicio funcionando no es seguridad: es un servidor apagado.
La inteligencia artificial entra por la misma puerta que todo el mundo
Volviendo al principio: todo esto existía para que pudiéramos avanzar con IA sobre una base defendible.
Cuando esa base quedó en pie, la IA entró obedeciendo las mismas reglas. No se abrió ninguna excepción para ella — y vale decirlo, porque abrir una excepción para el sistema nuevo es exactamente como nacen las brechas.
En la práctica: un asistente de IA no tiene cuenta propia ni permiso propio. Actúa en nombre de una persona, con autorización explícita de ella, y el acceso concedido es obligatoriamente menor o igual al que esa persona ya tendría en pantalla. Nadie gana permisos por conectar un asistente.
Cada acción que la IA puede ejecutar fue clasificada, una por una, por cuánto duele. Una acción reversible se ejecuta y queda registrada. Una acción con efecto fuera de la organización devuelve lo que iría a ocurrir y se detiene, esperando confirmación. Una acción que mueve dinero o patrimonio exige un ensayo previo registrado y confirmación humana.
Y el dato personal identificable se sustituye antes de que cualquier fragmento salga hacia un servicio externo, con registro de cuánto salió.
El relato completo de ese trabajo — incluidas las seis hipótesis nuestras que la medición desmintió — está en la publicación anterior.
Quién autoriza una transferencia de datos
La transferencia de datos hacia afuera solo ocurre con autorización de nuestro director de protección de datos. No es una potestad compartida, no es aprobación por conveniencia de quien está haciendo la tarea.
Sí, eso crea un cuello de botella. Es el cuello de botella que queremos. Un dato que sale de la organización sin alguien responsable de haberlo dejado salir es un dato que nadie consigue explicar después — y “después” suele ser frente a un titular, a un financiador o a una autoridad.
Un ejemplo real, porque un principio sin ejemplo es adorno.
Cuando decidimos poner nuestro tráfico detrás de esa protección de borde, apareció un conflicto que ningún manual resuelve: pasar el tráfico por una red externa significa que esa red ve lo que pasa. Para la mayor parte de nuestros sistemas eso es aceptable y está regulado por un contrato de tratamiento de datos. Para el canal de denuncias no lo era — porque su diseño guarda la dirección de quien denuncia de forma irreversible, a propósito, para que ni nosotros consigamos saber quién fue.
La decisión no fue del equipo de tecnología. Se llevó al director de protección de datos, se decidió con base legal y quedó registrada por escrito en nuestra documentación de arquitectura, junto con el contrato que la sostiene. Y el sistema más sensible de todos quedó deliberadamente fuera del borde: aceptamos perder protección contra ataques para no perder el anonimato.
Escribo esto porque es el tipo de decisión en que la seguridad y la privacidad tiran hacia lados opuestos, y alguien necesita tener autoridad para decir cuál de las dos cede. Si esa persona no existe en tu organización, la decisión se tomará igual — por quien esté configurando, solo, a las once de la noche.
Saber dónde está cada dato
Hay una parte de este trabajo que no es sobre ningún intruso. Es sobre la persona a quien pertenece el dato.
Mantenemos una plataforma que centraliza el mapeo de los datos personales y sensibles repartidos por nuestros sistemas — qué existe, dónde está, por qué está ahí y cómo está siendo tratado.
La razón es directa. La ley le da al titular el derecho de pedir acceso, corrección, portabilidad y eliminación de sus propios datos. Solo que ese derecho no vale nada si la organización no sabe dónde está la información. Una organización que necesita tres semanas y un grupo de trabajo para responder “¿qué datos tienen sobre mí?” no está cumpliendo la ley — está fingiendo cumplirla, y contando con que nadie pregunte.
Aquí, cuando un titular pide, la respuesta sale en pocos clics. Para eso existe el mapeo: no para tener una política publicada, sino para conseguir responder.
Formación, porque la falla casi nunca es de la máquina
Todos los años el equipo recibe formación, y a lo largo del año recibe informes — qué está permitido, qué no, cómo proteger el dato de quien confió en nosotros, y cómo reconocer un intento de estafa.
Insistimos en esto porque casi ningún incidente empieza en un servidor. Empieza en alguien con prisa, en un pedido que parecía legítimo, en un mensaje que llegó en el momento justo. Se puede cifrar todo y aun así perderlo todo por un “confírmame esto rapidito”. Contra eso no existe configuración. Existe gente formada.
Lo que se puede llevar de aquí
Si este texto le sirve a otra organización de nuestro campo, que sirva por estos cinco puntos — todos independientes del presupuesto:
Mide antes de mejorar. Haz una auditoría contra un estándar externo antes de tocar cualquier cosa. Sin línea de base, no tienes cómo saber si mejoraste ni cómo probárselo a quien te financia.
Pide ayuda a quien la ofrece. La protección de nivel empresarial existe gratis para organizaciones de interés público. El Proyecto Galileo es un camino real, y la mayor parte de las organizaciones elegibles simplemente no sabe que existe. Vale para más cosas: identidad corporativa, acceso de confianza cero y verificación anti-robot tienen capa gratuita que cubre a una organización de nuestro tamaño.
Atiende la salida, no solo la entrada. El filtrado de DNS es barato, rápido de encender y cubre el escenario más común de compromiso real.
Decide quién autoriza qué, por escrito. Roles definidos y una persona responsable por la transferencia de datos valen más que cualquier herramienta. Eso no cuesta ninguna licencia — cuesta una decisión.
Publica tus límites. Decir lo que todavía no haces es lo que le da peso a lo que dices que haces.
Solemos decir que las periferias no son lugar de espera, son lugar de comienzo. Vale también para esto. La seguridad de la información se volvió, en la cabeza de mucha gente, cosa de bancos y multinacionales — algo que una organización social no alcanza y por eso ni siquiera intenta.
No es verdad. Lo que la mayor parte de esto exige no es dinero: es decidir que el dato de un joven de la periferia merece el mismo cuidado que el dato de un cliente de banco.
Lo merece. Y por eso ordenamos la casa.
Referencias y lecturas
- Slack — Security at Slack: how Slack protects your data. La publicación que inspiró esta. https://slack.com/intl/pt-br/blog/collaboration/security-at-slack-how-slack-protects-your-data
- Ley n.º 13.709/2018 — Ley General de Protección de Datos Personales de Brasil (LGPD). https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2018/lei/l13709.htm
- Autoridad Nacional de Protección de Datos (ANPD), Brasil. https://www.gov.br/anpd/pt-br
- Cloudflare — Proyecto Galileo. Protección gratuita de nivel empresarial para organizaciones de interés público, desde 2014. https://www.cloudflare.com/galileo/
- Cloudflare — Informe de aniversario del Proyecto Galileo: ciberataques contra la sociedad civil. https://cfl.re/cyberattacks-against-civil-society-project-galileo-anniversary-report
- Cloudflare One — documentación de la plataforma de acceso y filtrado. https://developers.cloudflare.com/cloudflare-one/
- Cloudflare Turnstile — verificación anti-robot sin rastreo del usuario. https://developers.cloudflare.com/turnstile/
- NIST SP 800-207 — Zero Trust Architecture. La norma que formalizó el concepto de confianza cero. https://csrc.nist.gov/pubs/sp/800/207/final
- Forrester Research — No More Chewy Centers: Introducing the Zero Trust Model of Information Security (John Kindervag, 2010). El trabajo que acuñó el término.
- Google — BeyondCorp. La primera implementación a gran escala del modelo. https://cloud.google.com/beyondcorp
- CIS Benchmarks — Center for Internet Security. El estándar de configuración segura contra el cual auditamos nuestros servidores. https://www.cisecurity.org/cis-benchmarks
- Casa Hacker — La IA que nos interesa no responde correos. El relato del trabajo de datos que esta publicación sostiene. https://casahacker.org/publicacoes/a-ia-que-nos-interessa-nao-responde-e-mail/